
Day 27 停在一句話:鏈跑得通,不代表它跑得對——那我怎麼知道哪些地方曾經壞過?最直接的辦法是翻記憶庫。我在 2026-10-04 重跑了一次,時間窗從 2025-11-11 第一筆到當天上午:全表 16143 筆,類別是錯誤的 512 筆、警告的 381 筆,合計 893 筆,只佔 5.53%。Day 11 盤點時這個比例換算是 5.71%,兩週後反而降了,因為進度和筆記寫得比錯誤和警告快。矛盾就在這裡:錯誤和警告不到 6%,可是派工規則裡那些「一律」「禁止」「先問」,我回頭追了 12 條,11 條都找得到直接觸發它的那一筆紀錄。所以這篇不看成功,只看壞掉的東西壞在哪一層。
先挑幾次讓我立規則的事故,照月份排。
4 月,模型把我一句含糊的話讀成「刪掉」,遞迴刪除了 9 份還沒進版控的分析報告,救不回來。之後規則寫死:遞迴刪除前必須列出完整路徑,等我明確同意。這是後面那張對照表裡,唯一一次真正算「模型答錯」的。
5 月,一次改動只落在背景的隔離工作副本,我實際在用的主目錄沒吃到,看起來就像「沒修好」。後來隔離工作副本整個被禁用。
8 月,記憶查詢工具寫死用「更新時間」篩近四週,而舊資料的更新時間早被批次遷移壓平,查詢靜默回空,我誤判資料不存在。這是我自己寫的工具有缺陷,模型沒有答錯任何事。同一個月,服務端安全機制誤判一則任務描述,session 被自動換到舊一代模型,畫面上看不太出來。月底我又清出兩套已經沒有任何地方在用的瀏覽器二進位快取,合計約 3.9G,之後這兩類自動化套件直接禁裝。
9 月最密。無人值守的循環碰到要人批准的動作,沒人可批,就靜默停等了 39 分鐘;規則當天改成「要問人」一律改判「擋下」。同月,單一高階執行者跑了 343 次呼叫、約 41.9 美元等價成本,之後單一執行者的工作量有了上限。月底我用隔離環境的帳號開了主控,收尾的 hook 找不到檔案、每輪報錯,攔截層也不在位。
把這些排在一起看,壞掉的有我自己寫的工具、我搭的環境、我定的流程,各佔多少要看下面的分布。模型那一次最痛,但在這幾次裡只有一次。
分類之前先交代口徑,這比數字本身重要。893 筆裡有 84 筆記在資安演練名下,是安全研究紀錄、不是工具鏈事故,摘要還含區網位址,所以只計數、不送分類。剩下 809 筆才是分類母數。其中又有 12 筆摘要因機敏掃描命中被移除,只能判為資訊不足,暫歸防護層。所以下面的分布只涵蓋 809 筆,不涵蓋全部紀錄。分類也只看每筆摘要的前 180 字,根因寫在後段的長紀錄,可能被歸到表面症狀。
分類分兩段:首掃先標類別並標出拿不定的,拿不定的再送複核。首掃有 33.4% 送了複核,複核改判率 5.6%。
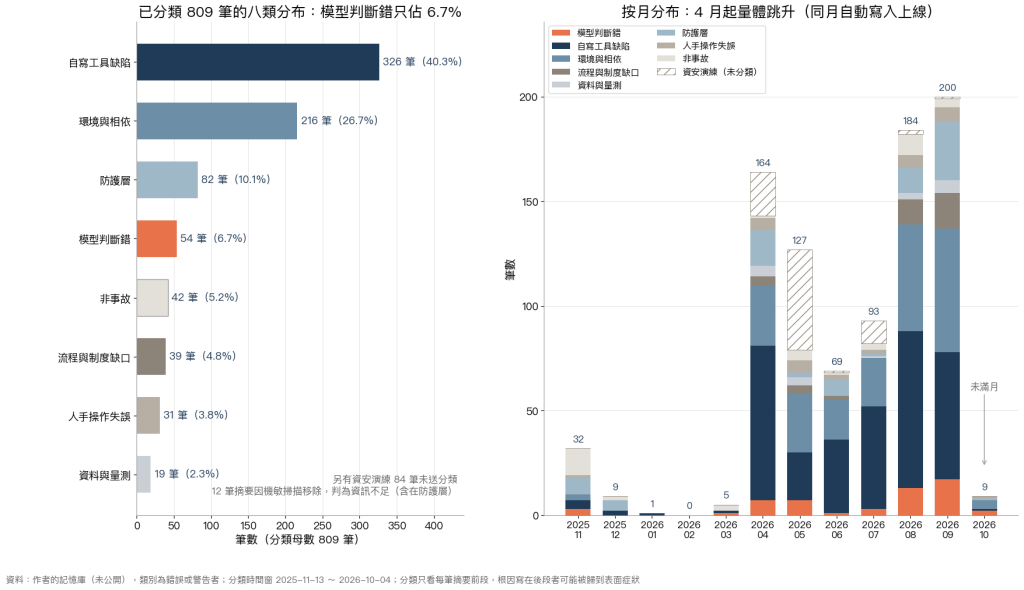
左:809 筆的八類分布,資安演練 84 筆另列、未分類。右:同一批紀錄連同 84 筆演練按月堆疊,2025-11-13 到 2026-10-04;10 月只含前 4 天,未滿月。
結果直接回答壞在哪一層。自寫工具缺陷 326 筆,佔 40.3%;環境與相依 216 筆,佔 26.7%;兩者合計三分之二。模型判斷錯只有 54 筆,佔 6.7%。把 42 筆其實不是事故的拿掉,以 767 筆為母數,不是模型答錯的佔 93.0%。
時間上有兩件事。第一,4 月起量體跳升,之前每月不超過 32 筆;同一個月,記憶自動寫入上線。這是並列的事實,我沒有逐月核對寫入來源,不把它寫成因果。第二,流程與制度缺口一共 39 筆,8、9 兩月就佔 29 筆,74%——這兩個月也是我密集改派工和外包制度的時候;制度變更我沒有逐筆計數,只當並列的觀察。
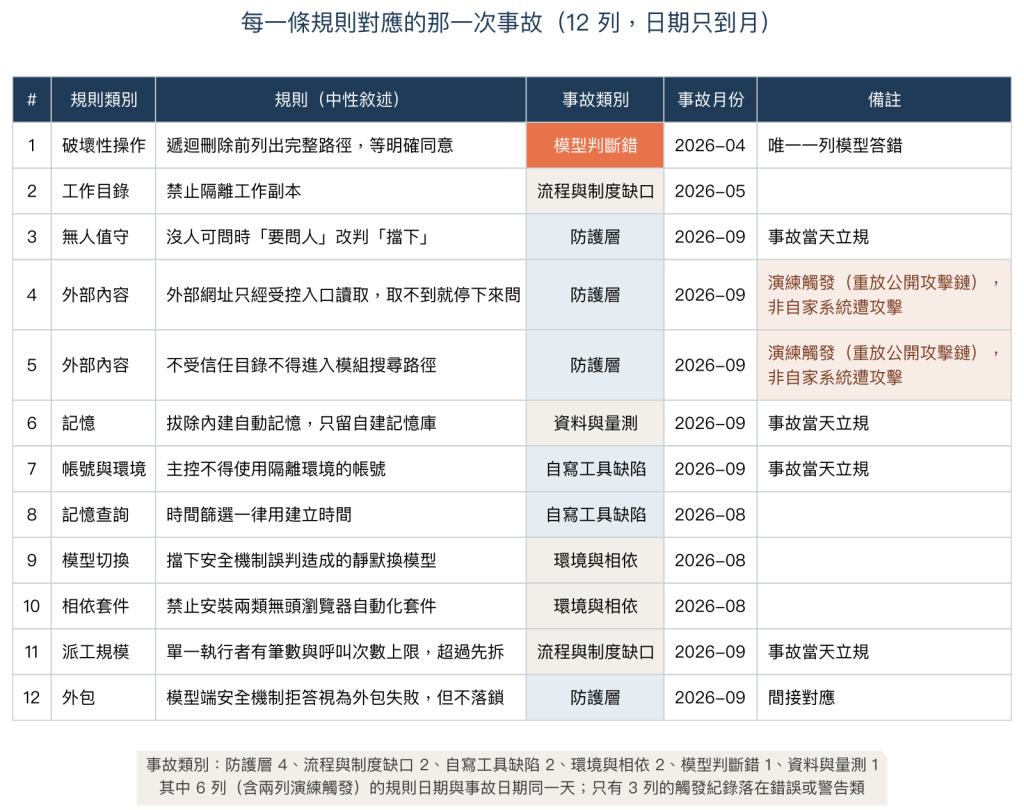
每一條規則對應的那一次事故,共 12 列,日期只到月。標註的兩列為演練觸發(重放公開攻擊鏈),非自家系統遭攻擊;最後一列為間接對應。
第二張圖反過來,從規則往回找事故。12 條規則裡,11 條找得到直接對應的觸發紀錄,另 1 條只算間接對應;12 列中有 6 列的規則日期和事故日期是同一天——制度是事故當天補上的。有兩列來自資安演練:我拿一篇公開的攻擊鏈手法逐步重放,自建攔截層七個步驟全部放行,屬於演練觸發(重放公開攻擊鏈),非自家系統遭攻擊。12 列的事故類別裡,防護層 4 列,模型答錯仍然只有 1 列。
我原本的直覺是:錯多半出在模型,該換更好的模型、寫更長的提示。分布說的是另一件事。三分之二壞在我自己寫的工具和工具底下的環境與相依,補洞的位置也該在那裡。
回頭看規則怎麼補的,大致有幾種形狀。第一種是改掉工具的預設,例如記憶查詢一律用建立時間篩,不再讓一個被壓平的欄位決定結果。第二種是讓「要問人」的地方在沒人時也能落地,無人值守時一律擋下,而不是停著等。第三種是在派工前加量體上限,超過先拆,不等跑完才發現。還有一種比較安靜:把環境收窄,不再用的套件禁裝,帳號和環境對不上的主控直接不開。四種都不是在教模型更聰明,而是讓它在我搭的環境裡少踩坑。
盤點本身也變成一個方法。往後立一條規則時,我要求它指得出觸發的那一次事故;指不出來的,就標明是預防性的。反過來,往後新增一筆錯誤紀錄時,我先問它屬於哪一層,而不是先問模型哪裡錯。這張分類表比任何一條單獨的規則都有用,因為它告訴我下一個洞最可能出在哪一層。
這個結論本身也有誤差。分類是看摘要判的,誤差主要來自摘要截斷和那 12 筆移除。但就算送複核的那批全部改判成模型答錯,模型那一類也只到 40%,仍然不是多數。「大半不是模型答錯」這句話,在這個假設下還站得住;沒送複核的 539 筆首掃誤判率未知,不在估算裡。
這次盤點有個不太舒服的副產品。對照表 12 列裡,只有 3 列的觸發紀錄落在錯誤或警告類,其餘 9 列記在筆記、決策或進度裡。也就是說,逼出規則的那一次,多數當下沒有被我歸檔成錯誤。5.53% 只數到歸檔成錯誤和警告的那些,不是事故的全貌。
補完的洞看得到,因為有一條規則指著它。沒補的洞呢?它們可能就躺在其他類別的紀錄裡,當時被當成一般進度記下,之後沒有人回頭把它們叫做事故。從規則往回找,只找得到已經補上的那些。明天換個方向,直接看這套東西現在還壞著的地方。
明日預告:Day 29|這套東西現在仍然爛的地方


 iThome鐵人賽
 看影片追技術